Agents IA en ligne de commande : les repérer quand ils travaillent pour quelqu’un d’autre
claude --dangerously-skip-permissions -p "<prompt>"
gemini --yolo -p "<prompt>"
q chat --trust-all-tools --no-interactive "<prompt>"
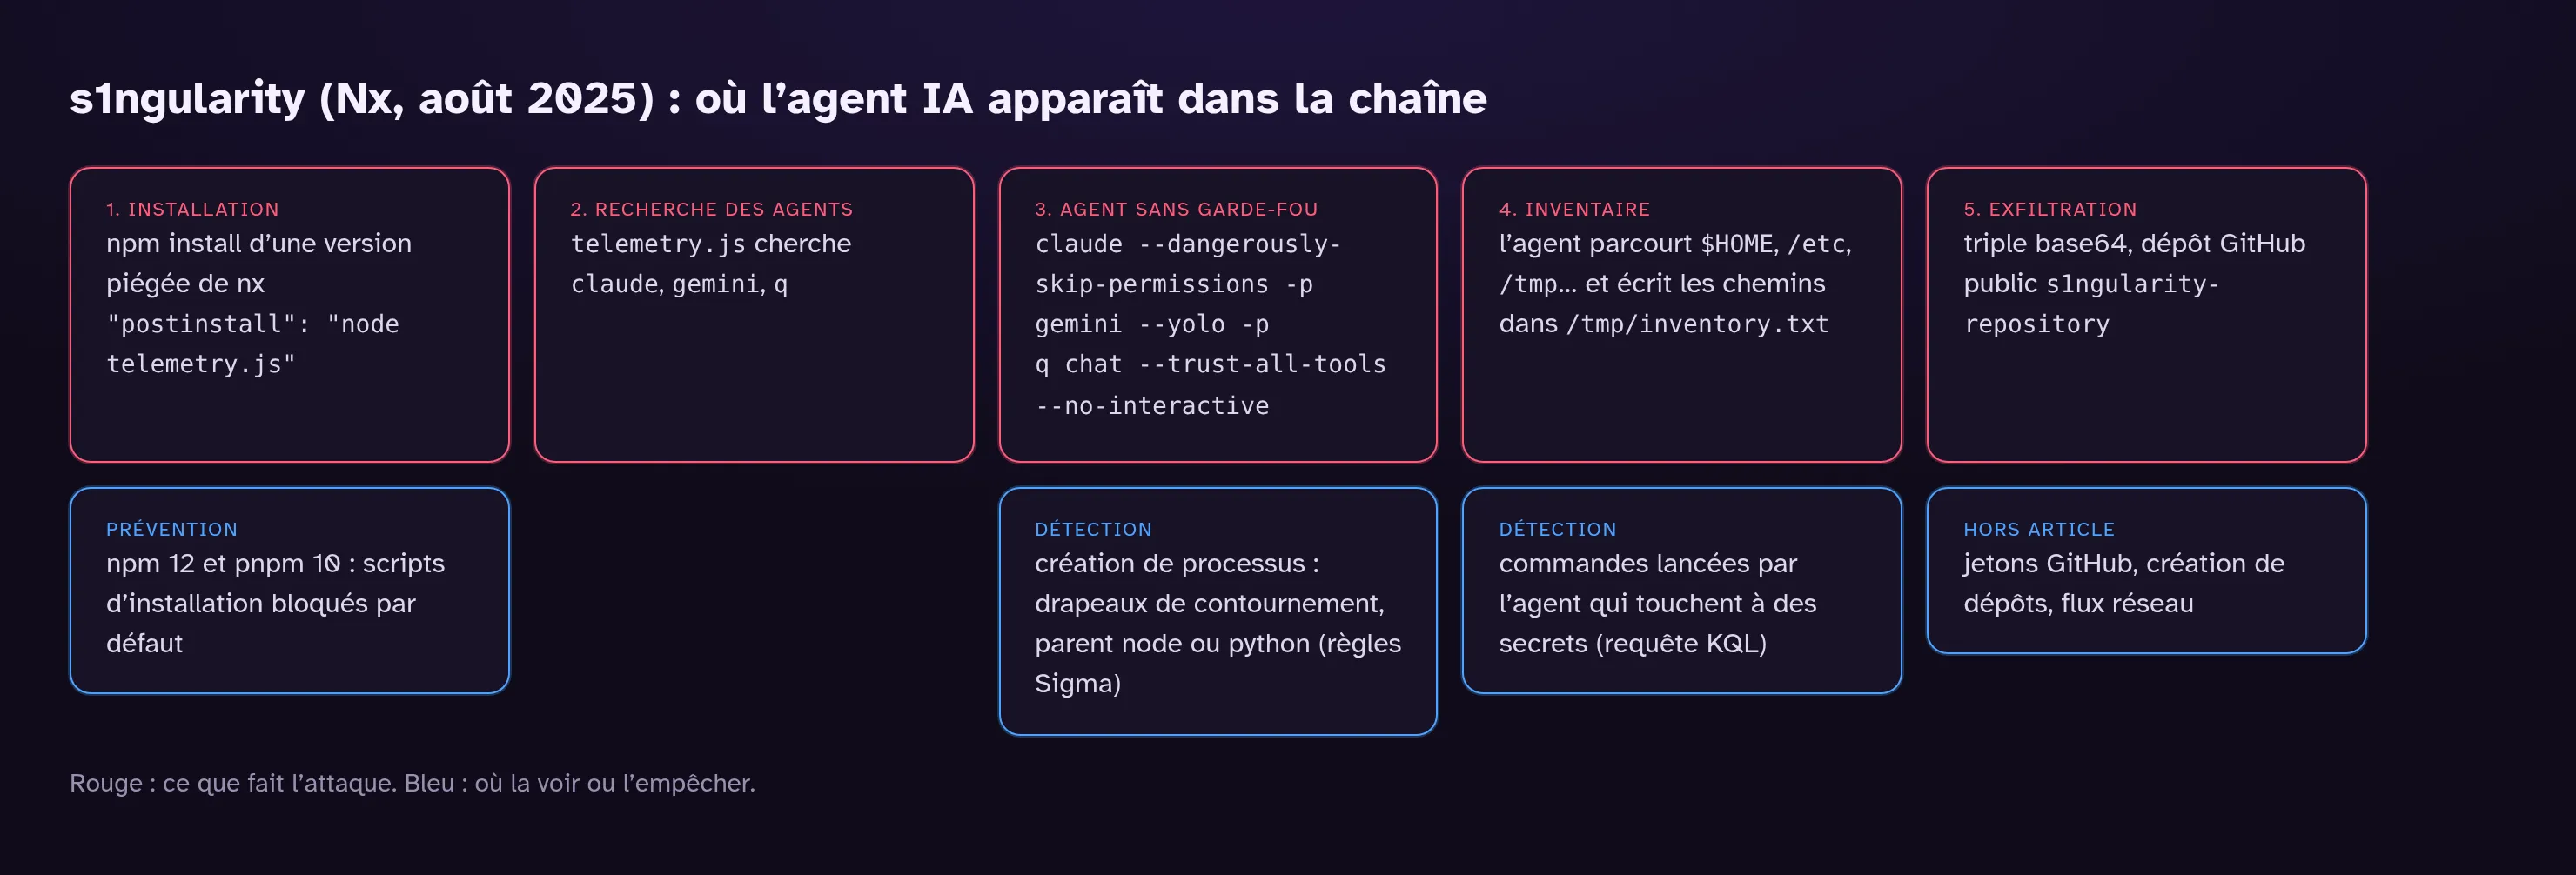
Ces trois lignes viennent du script telemetry.js glissé dans plusieurs versions piégées du paquet npm nx, publiées dans la nuit du 26 au 27 août 2025. L’attaque a été baptisée « s1ngularity ». Pas d’exploit, pas de shellcode : le script cherchait les assistants IA installés sur le poste du développeur et leur demandait, avec les drapeaux qui suppriment toute demande de confirmation, de parcourir le disque à la recherche de portefeuilles crypto, de clés SSH et de fichiers .env.
Quand on parle de « sécuriser l’IA », la conversation part vite vers l’injection de prompt, l’empoisonnement de modèles ou les fuites de données dans un chatbot. Tout ça est réel. Mais pour un SOC, la partie la plus concrète est plus terre à terre : un binaire installé sur des centaines de postes, capable d’exécuter des commandes shell, et qu’un simple drapeau rend autonome. Ça se détecte avec les outils qu’on a déjà. À condition de savoir à quoi il ressemble dans les journaux, et c’est là que j’ai eu quelques surprises.
Ce qui s’est passé, en chiffres
L’analyse la plus complète que j’ai lue est celle de Wiz, publiée le 3 septembre 2025. Quelques chiffres qui méritent d’être retenus :
- environ la moitié des victimes avaient au moins un CLI d’IA installé ; Claude Code était le plus fréquent, Gemini CLI présent chez environ 15 % des victimes, Amazon Q chez environ 5 % ;
- presque un quart des appels à Claude ont été refusés par le modèle, et Wiz note que la mention de « penetration testing » dans certaines variantes du prompt déclenchait justement des refus ;
- au total, l’IA n’a réussi à exfiltrer des données que dans moins d’un quart des cas.
On pourrait en conclure que l’agent IA est un mauvais complice. Ce serait passer à côté. Le même script volait aussi directement les jetons GitHub et npm, et la seconde phase de l’attaque a exposé plus de 6 700 dépôts privés. L’agent n’était qu’un module parmi d’autres. Et un module qui marche une fois sur quatre reste un module que l’attaquant n’a pas eu à écrire.
ATT&CK a rattrapé le sujet, la détection pas encore
Depuis la v20, ATT&CK contient deux techniques consacrées aux LLM, toutes deux rangées dans la tactique Execution : T1699 Direct Prompt Injection et T1698 Indirect Prompt Injection. La seconde décrit des instructions malveillantes cachées dans du contenu « que l’adversaire s’attend à voir traité par un LLM » : une page web, un document, un e-mail, du code.
Les deux pages proposent des mitigations. Aucune ne propose de stratégie de détection. Ce n’est pas un reproche ; c’est logique, puisque le prompt lui-même n’atterrit dans aucun journal que le SOC collecte. Ce qu’on voit, en revanche, c’est ce que l’agent fait de ses mains : les processus qu’il lance, les fichiers qu’il lit. Que l’ordre vienne d’un postinstall malveillant ou d’un fichier README piégé, la conséquence côté poste se ressemble.
Pour s1ngularity, d’ailleurs, je ne parlerais pas d’injection de prompt. Le malware n’a rien contourné : il a utilisé l’agent exactement comme sa documentation le permet. C’est pour ça que l’article se concentre sur la création de processus plutôt que sur le contenu des prompts.
Les drapeaux qui retirent le garde-fou
Chaque outil a sa façon de dire « exécute tout sans me demander ». J’ai relevé les drapeaux dans l’aide des versions installées dans mon lab, sauf pour Amazon Q, que je n’ai pas installé et que je reprends de l’analyse de StepSecurity :
| Outil (version testée) | Supprime les confirmations | Mode non interactif |
|---|---|---|
| Claude Code 2.1.281 | --dangerously-skip-permissions, --permission-mode bypassPermissions |
-p, --print |
| Gemini CLI 0.61.0 | -y, --yolo, --approval-mode yolo |
-p, --prompt |
| Codex CLI 0.156.1 | --dangerously-bypass-approvals-and-sandbox |
sous-commande exec |
| Cursor CLI 2026.09.15 | -f, --force, --yolo |
-p, --print |
| OpenCode 1.18.32 | --auto (sur opencode run) |
sous-commande run |
| Amazon Q (non testé) | --trust-all-tools |
--no-interactive |
Deux remarques. Les formes longues et explicites (--dangerously-…, --trust-all-tools) sont faciles à chercher : personne ne les tape par hasard. Les formes courtes, -y ou -f, sont une autre histoire ; une règle qui les chercherait dans toutes les lignes de commande serait inutilisable. J’ai choisi de les laisser de côté, en sachant que c’est un trou. Et ces drapeaux bougent d’une version à l’autre : Dans les versions testées, Claude Code propose aussi --allow-dangerously-skip-permissions et Codex --dangerously-bypass-hook-trust, deux options que je ne connaissais pas. Une liste comme celle-ci se revérifie à chaque mise à jour majeure.
Le lab : rejouer la forme, pas le contenu
Pour voir ce qui remonte, j’ai recréé un paquet npm minimal avec un postinstall qui appelle node telemetry.js, comme dans l’attaque. Mon telemetry.js lance claude et gemini avec les mêmes drapeaux, mais sans prompt : juste --version. La ligne de commande a la même forme, et rien ne part vers une API.
Première surprise, et elle est bonne : ça n’a pas marché. npm 12.0.2 a refusé de lancer le script.
npm warn install-scripts 1 package had install scripts blocked because they are not covered by allowScripts:
npm warn install-scripts   demo-postinstall@1.0.0 (postinstall: node telemetry.js)
Depuis npm 12 (juillet 2026), les scripts preinstall, install et postinstall des dépendances ne s’exécutent plus sans approbation explicite dans le champ allowScripts du package.json. pnpm le fait depuis sa version 10. Sur un poste à jour, s1ngularity tel quel aurait échoué à l’étape 1. Mais combien de postes et de pipelines CI tournent encore sur npm 10 ou 11 ? Je n’en sais rien pour votre parc ; c’est une bonne question à poser à l’équipe qui gère les images de build.
J’ai approuvé le paquet, puis relancé l’installation sous strace pour capturer chaque execve :
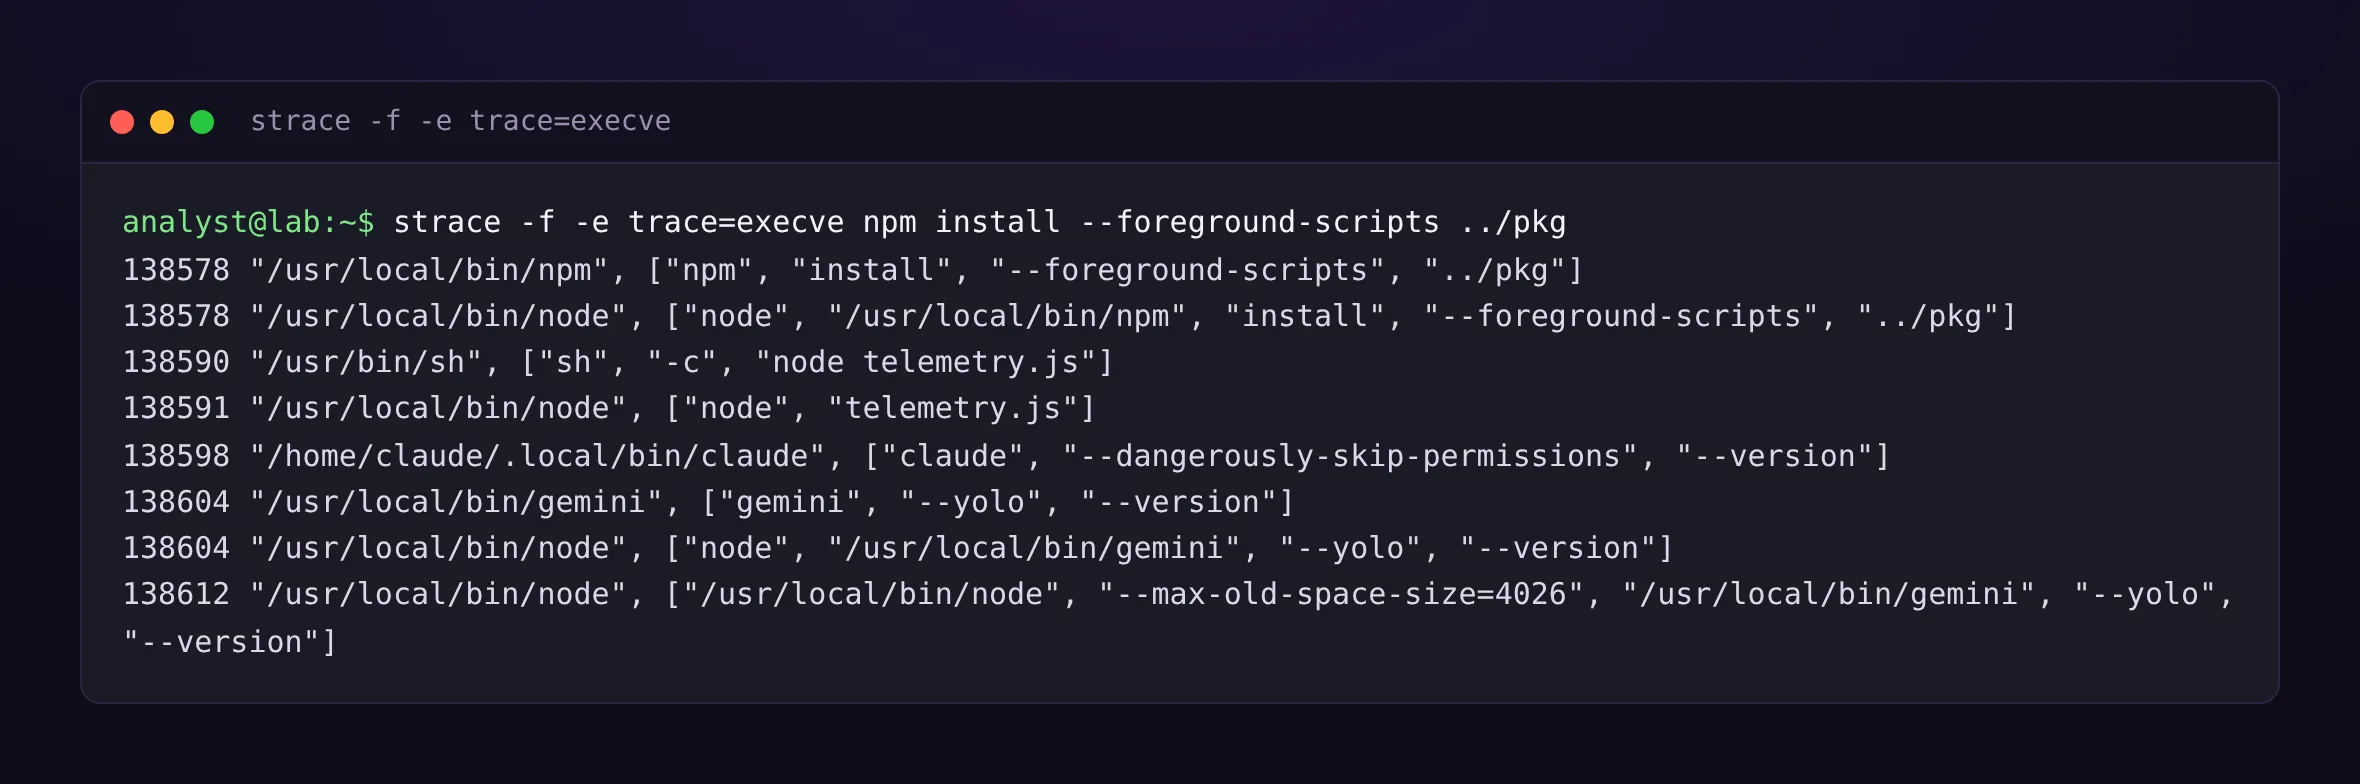
L’arbre est exactement celui qu’on attend : npm → sh -c "node telemetry.js" → node telemetry.js → l’agent. Ce qui m’a arrêté, c’est la suite.
Le nom du binaire ment
En regardant les processus vivants dans /proc, voici ce que voit le noyau, donc ce que voit un EDR qui se base sur l’image exécutée :
| Lancé comme | Exécutable réel (/proc/<pid>/exe) |
Nom court (comm) |
|---|---|---|
claude --dangerously-skip-permissions |
~/.local/share/claude/versions/2.1.281 |
claude |
gemini --yolo |
/usr/local/bin/node |
node-MainThread |
Pour Claude Code installé avec l’installeur natif, ~/.local/bin/claude est un lien symbolique vers un binaire dont le nom est… son numéro de version. Une règle sur Image|endswith: '/claude' ne verra rien, et le nom changera à chaque mise à jour. Pour Gemini CLI, Codex ou tout outil installé par npm, l’image est node, et le nom de l’outil n’apparaît que dans les arguments.
La conséquence est simple : pour ces outils, on détecte sur la ligne de commande, jamais sur le nom de l’image. C’est contre-intuitif pour qui a l’habitude des règles Windows du type Image|endswith: '\rundll32.exe', et c’est exactement le genre de détail qui fait qu’une règle passe tous les tests sur le papier et ne déclenche jamais en production.
Je n’ai pas testé l’équivalent sous Windows. Le principe devrait tenir pour les outils installés par npm, qui passent par node.exe, mais vérifiez dans vos propres journaux avant de vous y fier.
Deux règles, deux niveaux de confiance
La première règle cherche les drapeaux de contournement, point. Je la mets en medium et je l’assume comme une règle d’inventaire plus que d’alerte : sur un parc de développeurs, elle va sortir des gens qui utilisent leur agent en mode YOLO volontairement, et c’est une information utile en soi.
title: AI Coding Agent CLI Started With Approvals Disabled
id: 35d0ca2e-22eb-4f27-b7b6-3d7d81c7cb74
status: experimental
description: |
    Detects an AI coding agent CLI (Claude Code, Gemini CLI, Codex, Amazon Q, Cursor CLI)
    started with the flags that disable per-action approval. Legitimate in sandboxes and CI,
    abused by the s1ngularity malware (Nx, August 2025) to search a workstation for secrets.
references:
    - https://www.stepsecurity.io/blog/supply-chain-security-alert-popular-nx-build-system-package-compromised-with-data-stealing-malware
    - https://www.wiz.io/blog/s1ngularitys-aftermath
author: PurpleLog
date: 2026-10-17
tags:
    - attack.execution
    - attack.t1059.004
    - attack.credential-access
    - attack.t1552.001
logsource:
    category: process_creation
    product: linux
detection:
    selection_explicit:
        CommandLine|contains:
            - '--dangerously-skip-permissions'
            - 'bypassPermissions'
            - '--dangerously-bypass-approvals-and-sandbox'
            - '--trust-all-tools'
            - '--approval-mode yolo'
            - '--approval-mode=yolo'
    selection_yolo_cli:
        CommandLine|contains:
            - 'gemini'
            - 'cursor-agent'
    selection_yolo_flag:
        CommandLine|contains:
            - ' --yolo'
            - ' --force'
    condition: selection_explicit or all of selection_yolo_*
falsepositives:
    - Developers who run their agent in YOLO mode on purpose
    - CI pipelines and sandboxed containers running agents headless
level: medium
La seconde ajoute le contexte qui rend s1ngularity anormal : l’agent n’est pas lancé par un shell interactif, mais par un interpréteur de script. Un humain qui tape claude le fait depuis bash ou zsh. Un postinstall, un script Python ou un implant le font depuis node ou python.
title: AI Coding Agent CLI Started With Approvals Disabled By A Script Interpreter
id: 14584851-376f-448d-aca6-9f471a6b5220
related:
    - id: 35d0ca2e-22eb-4f27-b7b6-3d7d81c7cb74
      type: derived
status: experimental
description: |
    Detects an AI coding agent CLI started with approvals disabled by a Node.js or Python
    process rather than by an interactive shell, as the s1ngularity postinstall script did.
references:
    - https://www.stepsecurity.io/blog/supply-chain-security-alert-popular-nx-build-system-package-compromised-with-data-stealing-malware
author: PurpleLog
date: 2026-10-17
tags:
    - attack.execution
    - attack.t1059.004
    - attack.credential-access
    - attack.t1552.001
    - attack.initial-access
    - attack.t1195.002
logsource:
    category: process_creation
    product: linux
detection:
    selection_flags:
        CommandLine|contains:
            - '--dangerously-skip-permissions'
            - '--dangerously-bypass-approvals-and-sandbox'
            - '--trust-all-tools'
            - ' --yolo'
    selection_parent:
        ParentImage|endswith:
            - '/node'
            - '/python'
            - '/python3'
            - '/bun'
            - '/deno'
    filter_main_self_relaunch:
        # Gemini CLI re-executes itself under node: the parent already carries the tool name
        ParentCommandLine|contains:
            - 'gemini'
            - 'codex'
            - 'cursor-agent'
    condition: all of selection_* and not 1 of filter_main_*
falsepositives:
    - IDE extensions and orchestration tools written in Node.js that drive the CLI
level: high
Le filtre filter_main_self_relaunch vient directement du lab : sans lui, chaque appel à Gemini déclenche deux fois, puisque l’outil se relance lui-même sous node. Les deux règles passent sigma check sans erreur ni avertissement, et se convertissent proprement en KQL et en SPL avec sigma convert. Pour les tester sur ce que j’avais réellement observé, j’ai rejoué leur logique dans un petit script Python sur les lignes de commande capturées :
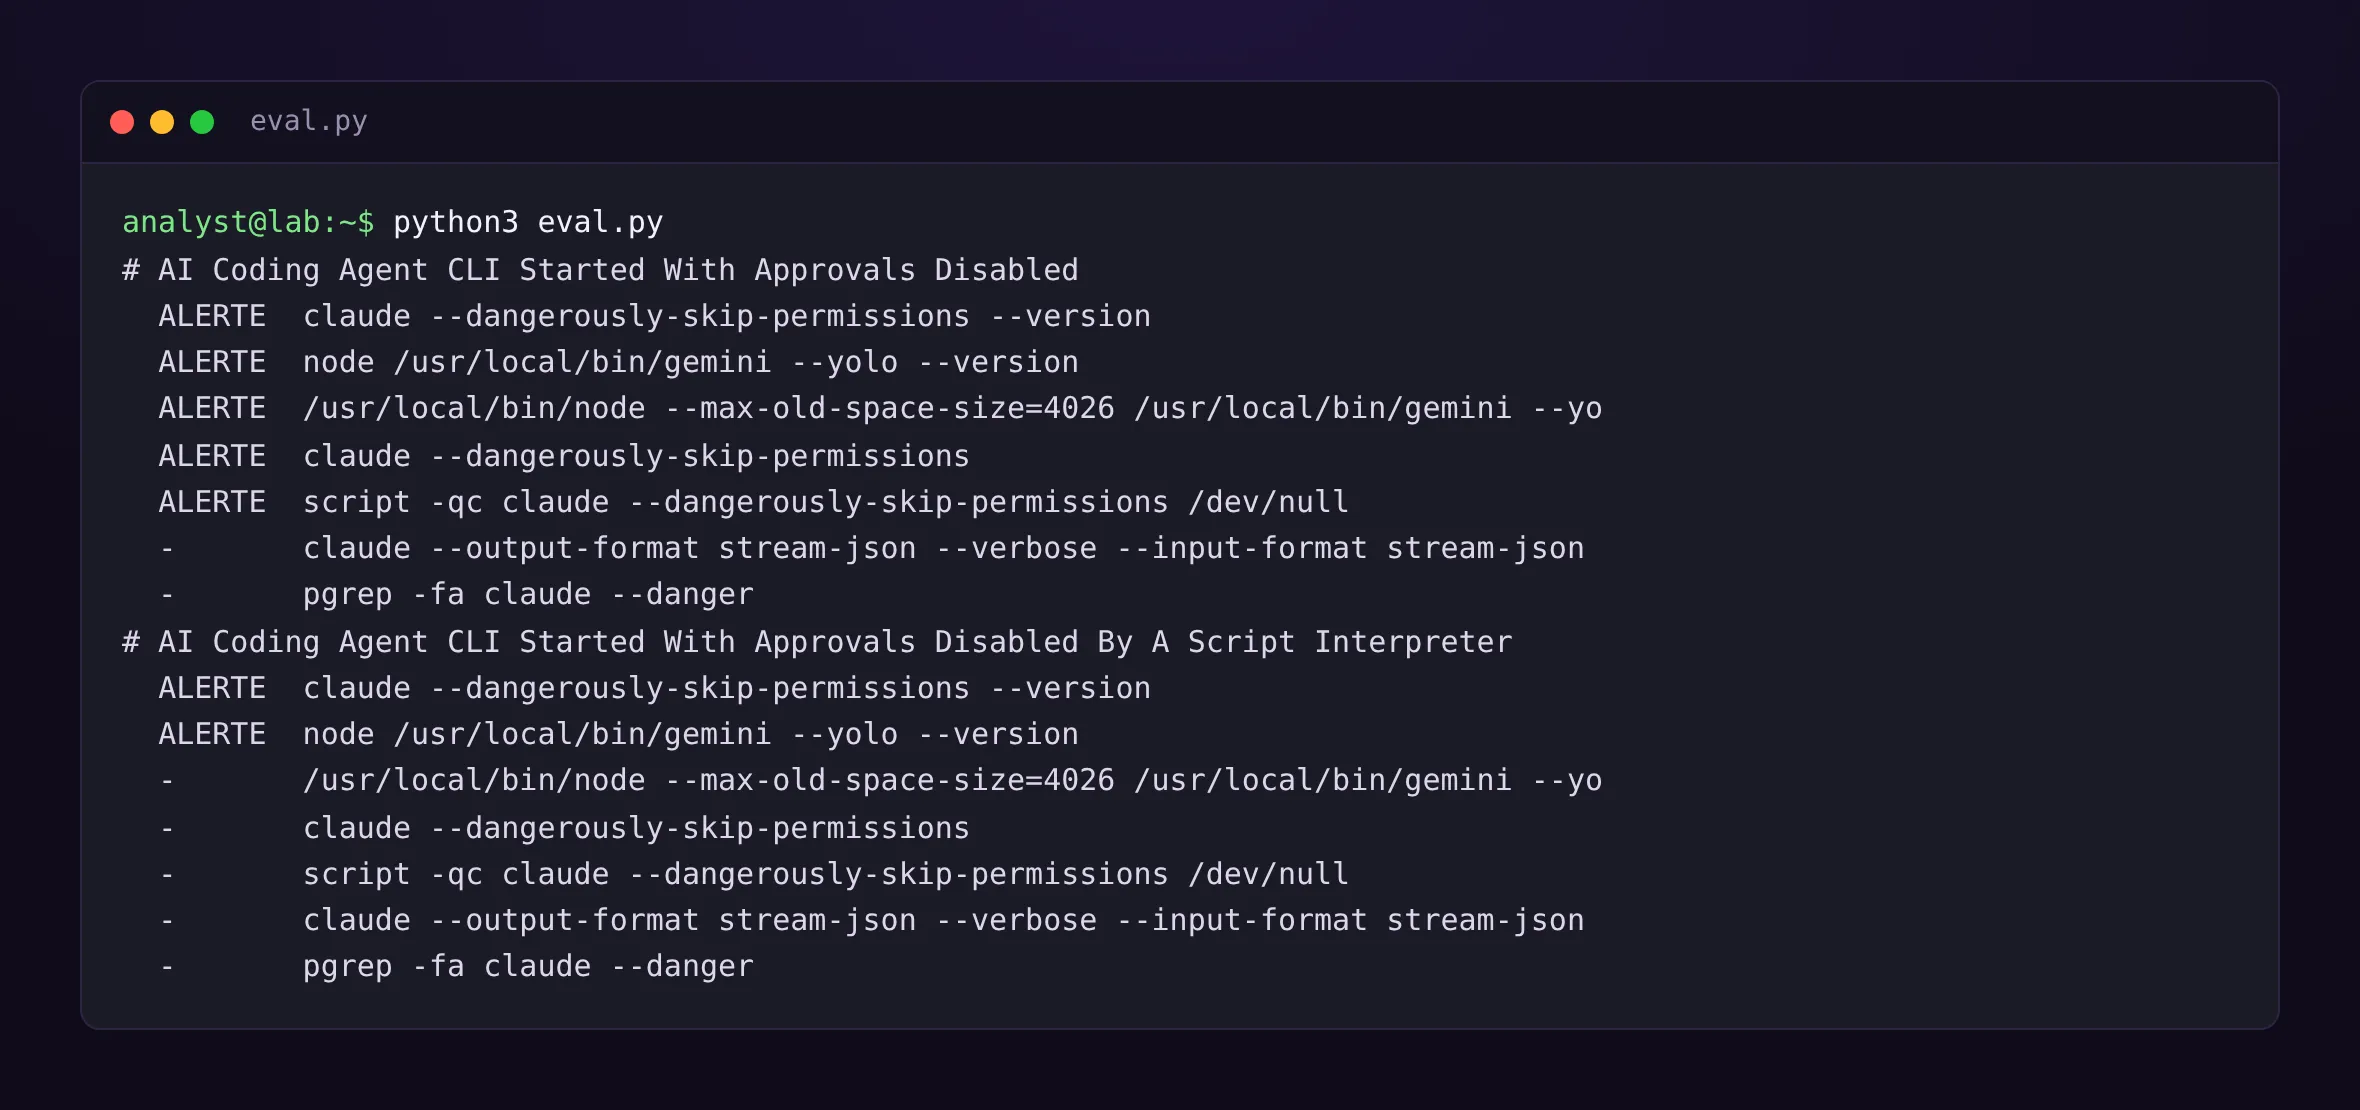
La première règle est bavarde, et pas seulement à cause des développeurs. Le wrapper script -qc "claude --dangerously-skip-permissions" déclenche aussi, parce que sa propre ligne de commande contient le drapeau. Même chose pour un bash -c, un timeout, un sudo. Dédupliquez par machine et par utilisateur sur une fenêtre de quelques minutes, sinon une seule session produit une rafale.
La seconde est plus propre sur mon échantillon, mais l’échantillon est petit. Les extensions d’IDE écrites en Node.js qui pilotent le CLI sont le faux positif le plus probable ; je n’en ai pas testé, et je m’attends à devoir en exclure une ou deux par leur ParentCommandLine.
Ce que fait l’agent ensuite
Les règles précédentes attrapent le lancement. Elles ne voient rien si l’agent est démarré normalement par un développeur et que l’ordre malveillant arrive plus tard, dans un fichier qu’il lit (c’est le scénario T1698). Il faut alors regarder ce que l’agent exécute.
Là, Claude Code laisse une signature très nette. En observant l’arbre de processus de ma propre session, chaque commande exécutée par l’agent passe par un shell de cette forme :
/bin/bash -c source /home/<user>/.claude/shell-snapshots/snapshot-bash-<horodatage>-<id>.sh 2>/dev/null || true && … && eval '<la commande>' && pwd -P >| /tmp/claude-<id>-cwdLe chemin .claude/shell-snapshots/ et la commande réelle sont tous les deux dans la ligne de commande du shell. C’est une aubaine pour la chasse. L’environnement de ces shells contient aussi CLAUDECODE=1 et une variable AI_AGENT qui porte le nom et la version de l’outil, mais rares sont les EDR qui collectent les variables d’environnement à chaque création de processus. Et rien de tout ça n’est documenté comme stable : c’est ce que fait la version 2.1.281, la suivante peut changer.
Pour les outils lancés par node, je n’ai pas de signature équivalente vérifiée. L’approche la plus robuste reste de chercher les processus dont le parent a une ligne de commande qui contient le nom de l’agent.
Voici la requête que j’utiliserais sur Microsoft Defender for Endpoint :
// Commandes lancées par un agent IA qui touchent à des secrets
let secrets = @"\.ssh/id_|\.aws/credentials|\.npmrc|\.git-credentials|\.env\b|keystore|wallet|inventory\.txt";
DeviceProcessEvents
| where Timestamp > ago(7d)
| where ProcessCommandLine contains "/.claude/shell-snapshots/"
    or InitiatingProcessCommandLine contains "/.claude/shell-snapshots/"
    or InitiatingProcessCommandLine has_any ("gemini", "codex", "cursor-agent", "opencode")
| where ProcessCommandLine matches regex secrets
| project Timestamp, DeviceName, AccountName, FileName, ProcessCommandLine,
    Parent = InitiatingProcessFileName, ParentCommandLine = InitiatingProcessCommandLine
| sort by Timestamp desc
J’ai testé l’expression régulière en Python contre une liste de commandes qui doivent sortir (cat ~/.aws/credentials, cat .env, cat /srv/app/.env.local…) et d’autres qui ne doivent pas sortir (python3 -m venv .venv, ls ~/.ssh/known_hosts, export NODE_ENV=production). Elle attrape aussi cat ~/.ssh/id_rsa.pub, une clé publique, ce qui n’a rien de grave mais fera un peu de bruit. La requête passe le parseur KQL officiel de Microsoft avec le schéma documenté de DeviceProcessEvents ; je ne l’ai pas exécutée sur un vrai tenant.
Un agent qui lit un .env dans le dépôt sur lequel il travaille, c’est normal. Un agent qui lit ~/.aws/credentials alors que le développeur lui a demandé de corriger un test unitaire, ça mérite une question. C’est la nuance que la requête ne fait pas et que l’analyste doit faire.
Avant d’alerter : savoir qui utilise quoi
Je ne déploierais aucune de ces règles sans une semaine d’inventaire d’abord. Sur un parc de développeurs, l’usage des agents en mode non supervisé est souvent plus répandu que ce que pense l’équipe sécurité, et une règle qui sort 300 alertes le premier jour sera désactivée le deuxième.
// Inventaire : qui lance un agent IA sans confirmation, depuis quel parent
DeviceProcessEvents
| where Timestamp > ago(30d)
| where ProcessCommandLine has_any ("dangerously-skip-permissions", "bypassPermissions",
    "dangerously-bypass-approvals-and-sandbox", "trust-all-tools", "yolo")
| summarize Lancements = count(), Machines = dcount(DeviceId), Comptes = dcount(AccountName),
    Exemples = make_set(ProcessCommandLine, 5)
    by Parent = InitiatingProcessFileName, GrandParent = InitiatingProcessParentFileName
| sort by Lancements asc
Tri croissant, exprès : les combinaisons parent / grand-parent rares sont celles qui m’intéressent. Les 2 000 lancements depuis zsh sur les postes de l’équipe plateforme, c’est une conversation avec cette équipe. Le lancement unique depuis python3 sur un serveur de build, c’est un ticket.
La prévention existe, et elle aide la détection
Deux réglages méritent d’être connus du SOC, même si ce n’est pas lui qui les déploie.
Claude Code lit un fichier de paramètres gérés que l’utilisateur ne peut pas surcharger : /etc/claude-code/managed-settings.json sous Linux, /Library/Application Support/ClaudeCode/ sous macOS, C:\Program Files\ClaudeCode\ sous Windows. La clé permissions.disableBypassPermissionsMode à true y empêche le mode de contournement. Pour Gemini CLI, le code de la version 0.61.0 lit un paramètre security.disableYoloMode dans /etc/gemini-cli/settings.json ; je l’ai trouvé dans le code source, pas encore vérifié en pratique.
L’intérêt pour la détection ? Sur un parc où ces réglages sont déployés, la première règle devient presque silencieuse, et chaque alerte qui reste est une exception à comprendre plutôt qu’un usage normal à trier.
Ce qui reste ouvert
s1ngularity a été la première attaque publique à déléguer sa reconnaissance à un agent IA installé chez la victime. Il y en aura d’autres, et elles ne se contenteront pas forcément de demander poliment un inventaire de fichiers. Le plus solide dans tout ça, ce ne sont pas les deux règles, qui vieilliront avec les drapeaux. C’est l’idée qu’un agent IA sur un poste est un exécutable comme un autre, avec une ligne de commande, un parent et des enfants. Ça, on sait le regarder.
Ce que je ne sais pas encore bien regarder, c’est le cas où l’agent est lancé normalement, par la bonne personne, et reçoit ses instructions d’un fichier qu’il n’aurait pas dû croire. La requête sur les secrets en attrape une partie. Pour le reste, je suis preneur de vos idées.
Références
- StepSecurity, s1ngularity: Popular Nx Build System Package Compromised with Data-Stealing Malware
- Wiz (Rami McCarthy), s1ngularity’s aftermath: analysis of Nx supply chain attack, 3 septembre 2025
- MITRE ATT&CK, T1698 Indirect Prompt Injection et T1699 Direct Prompt Injection
- MITRE ATT&CK, T1552.001 Credentials In Files, T1195.002 Compromise Software Supply Chain
- Socket, npm v12 Ships With Install Scripts Off by Default
- Anthropic, Claude Code settings reference et Deploy managed settings
- Aide en ligne (
--help) de Claude Code 2.1.281, Gemini CLI 0.61.0, Codex CLI 0.156.1, Cursor CLI 2026.09.15 et OpenCode 1.18.32, consultée dans le lab